
[October 2026 edition]
ローカルで動く判断モデルと Jev を M5 Pro Mac で試してみた
Published: Oct 8, 2026
Reading time: ~10 min
クラスメソッドの記事:AWS がリリースした判定専用モデル「Strands Decider 2B」を M4 Mac で試し、Kev・Jev と比べてみた を参考に、同じ Kiro Crew 型の日本語 20 問と判定文を使い、M5 Pro Mac 上のローカル判断モデルたちと Jev を比較しました。 Strands Decider 2B は、v19 と最新版の v21 との比較もしています。
Strands Decider 2B が Jev に匹敵する結果を示し、ローカル運用の候補として最良、Clef-flash も Jev に迫る十分な成績でした。
評価対象モデル
Strands Decider 2B
Strands Decider 2B は、2026 年 10 月 1 日に AWS の Strands Labs が公開した、約 19 億パラメータの小型判断モデルです。Qwen3.5-2B-Base の言語生成部分を外し、選択肢ごとの確率を返す pointer head を組み合わせています。元記事と同じ公開重み v19 と、最新版の v21 の両方を測定しました。
Clef-flash
Clef-flash は、Cloudflare が公開した 90 億パラメータの判断モデルです。Qwen3.5-9B を基盤とし、複数の設問を同時に採点できます。今回は Apple Silicon 向けの mlx-community/clef-flash-4bit を使いました。
laya
laya は、選択、段階評価、yes/no などの型付き判断を返すオープンソースの System 1 エンジンです。今回の多言語モデルは mmBERT-base を基盤とする約 3.2 億パラメータのエンコーダー型で、MLX 移植版を使いました。配布元の FP16 重みと、それを 8bit に変換した laya-multilingual-q8 の両方を同じ条件で測定しました。
Jev
Jev は、TypeSafe AI が提供する System One サービスの判断モデルです。状態と型付きの設問を受け取り、回答と確率を返します。今回は TypeSafe API の jev-latest を呼び出し、応答モデルは jev-1.13.0 でした。
検証環境
| 項目 | 構成 |
|---|---|
| マシン | Mac mini、Apple M5 Pro、メモリ 48 GB |
| OS | macOS 27.0.1 |
| Strands | v19・v21、MLX・MPS、torch 2.14.1、mlx-lm 0.32.0 |
| Clef-flash | 4bit、MLX |
| laya | multilingual FP16・q8、MLX、head_max_len=512 |
| Jev | TypeSafe API、jev-1.13.0 |
ローカルの 3 モデルは同じ Mac で動かしました。
測定方法
評価データは、AI コーディング依頼を振り分ける日本語 20 問と、日本語のサポート問い合わせ 24 件の 2 種類です。後者は 1 件につき 3 項目を判定するため、合計 72 判定になります。判定品質に加えて、逐次応答時間と複数プロセス構成の応答時間を測りました。
モデル振り分けには、クラスメソッドの記事:AWS がリリースした判定専用モデル「Strands Decider 2B」を M4 Mac で試し、Kev・Jev と比べてみた が公開した日本語 20 問を使いました。元記事は同じ設問の日本語版 20 問と英語版 20 問を評価していますが、今回は日本語版だけを対象としました。AI コーディング依頼を simple、medium、complex に振り分ける問題で、判定文は Kiro Crew のルーティング指示に選択肢の説明を加えた B_desc です。元記事の想定回答と許容回答を引き継ぎ、許容されたラベルに入った件数を「想定内」としました。
問い合わせ分類では、24 件それぞれについて次の 3 項目を判定しました。
- 担当部署:請求・技術・アカウント・営業の 4 択
- 緊急度:低・通常・高の 3 段階
- 返金要求:有無の真偽判定
各条件で 1 件をウォームアップしてから逐次実行し、品質と応答時間を集計しました。モデルを別プロセスに 1・2・4 個常駐させる試験では、同時数 1・2・4・8 を各 3 回実行しました。プロンプトキャッシュは無効にしました。
laya の FP16 と q8 は head_max_len=512 にそろえ、判定文、選択肢、設問本文が全件入ったことを検査しました。
評価結果
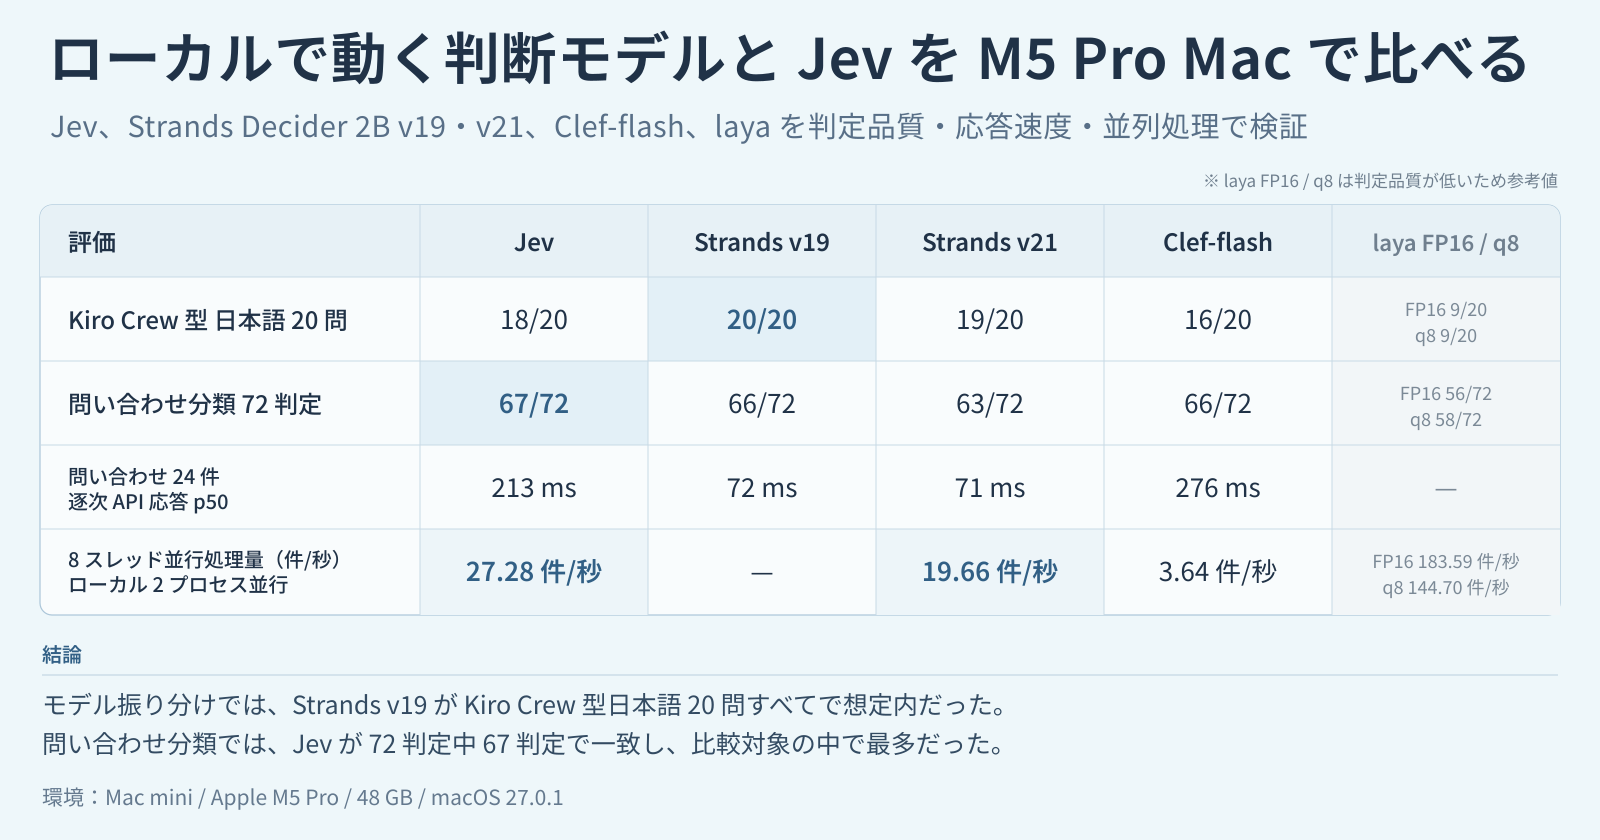
Kiro Crew 型 20 問のモデル振り分け評価
| モデル | 想定内 | 第一候補と一致 | 平均応答 | 20 問の所要時間 |
|---|---|---|---|---|
| Strands v19、MLX | 20/20 | 14/20 | 72 ms | 1.44 秒 |
| Strands v19、MPS | 20/20 | 14/20 | 264 ms | 5.29 秒 |
| Strands v21、MLX | 19/20 | 14/20 | 61 ms | 1.23 秒 |
| Strands v21、MPS | 19/20 | 14/20 | 172 ms | 3.44 秒 |
| Clef-flash 4bit、MLX | 16/20 | 14/20 | 315 ms | 6.31 秒 |
| laya multilingual FP16、MLX | 9/20 | 6/20 | — | — |
| laya multilingual q8、MLX | 9/20 | 6/20 | — | — |
Jev jev-1.13.0、API | 18/20 | 14/20 | 206 ms | 4.12 秒 |
Strands v19 は MLX と MPS のどちらでも 20 問、v21 はどちらでも 19 問が想定内に入りました。v21 では P11 が medium から simple、P19 が complex から medium に変わりました。P11 は許容範囲を外れ、P19 は両版とも許容範囲内です。リクエストハッシュ、返却モデル ID、応答本文は公開済みの版別結果で照合できます。
各版の最終ラベルは MLX と MPS で 20 問すべて一致しました。v21 の中央値は MLX が 54 ms、MPS が 153 ms で、今回の M5 Pro では MLX のほうが速く動きました。v19 と v21 は測定日とウォームアップ条件が異なるため、版間の応答速度は比較しません。
v21 が外した P11 は、会員限定ページの実現方法を尋ねる問題です。medium または complex が想定内でしたが、simple と判定しました。Clef は 4 問、Jev は 2 問が想定外でした。
laya は FP16 と q8 の両方が 20 問すべてを simple と判定し、11 問が想定外でした。入力を省略せずに渡しても両版の結果は同じであり、Kiro 型の低い判定品質は q8 への変換によるものではありません。
問い合わせ分類 72 判定の評価
| モデル | 72 判定の一致 | 担当部署 | 緊急度 | 返金要求 | 逐次応答 p50 |
|---|---|---|---|---|---|
| Strands v19、MLX | 66/72 | 24/24 | 18/24 | 24/24 | 72 ms |
| Strands v21、MLX | 63/72 | 24/24 | 15/24 | 24/24 | 71 ms |
| Clef-flash、MLX | 66/72 | 23/24 | 19/24 | 24/24 | 276 ms |
| laya FP16、MLX | 56/72 | 20/24 | 12/24 | 24/24 | — |
| laya q8、MLX | 58/72 | 21/24 | 13/24 | 24/24 | — |
| Jev、API | 67/72 | 24/24 | 19/24 | 24/24 | 213 ms |
Jev が 67 件で最も多く、Strands v19 と Clef が 66 件で続きました。Strands は両版とも担当部署と返金要求を全件正解し、緊急度は v19 が 18/24、v21 が 15/24 でした。a04・s01・s03 では、最も確率の高い緊急度が v19 の 0 から v21 の 1 に変わりました。この 24 件は手元で作成した問い合わせ例であり、特に緊急度の境界には評価者の判断が入ります。
laya の FP16 と q8 で判定が変わったのは 72 件中 3 件で、q8 が 2 件多く一致しました。Kiro 型では両版の判定が同じだったため、この結果だけで q8 の判定品質が高いとはいえません。
複数プロセス構成の性能評価
同じ M5 Pro Mac に Strands、Clef、laya をそれぞれ 1・2・4 プロセス常駐させ、問い合わせ 24 件を同時数 1・2・4・8 で各 3 回送りました。各プロセスはモデルを 1 個だけ保持し、推論バッチは 1 件に固定しました。表は HTTP 応答 p50 の中央値です。
| モデル | 1 個・同時 1 | 1 個・同時 8 | 2 個・同時 8 | 4 個・同時 8 |
|---|---|---|---|---|
| Strands v21 | 58.97 ms | 463.09 ms | 396.85 ms | 411.61 ms |
| Clef-flash | 283.27 ms | 2,277.11 ms | 2,192.64 ms | 2,278.11 ms |
| laya FP16(参考) | 7.15 ms | 53.89 ms | 43.09 ms | 39.88 ms |
| laya q8(参考) | 8.82 ms | 67.48 ms | 54.27 ms | 49.72 ms |
Strands は 2 個が最良で、4 個では待ち時間が再び増えました。Clef-flash は 2 個でわずかに改善しましたが、4 個では 1 個とほぼ同じでした。同じ GPU を共有するため、モデル数を増やしても応答時間は比例して短くなりません。全条件で 24/24 件が成功し、72 判定の一致数も変わりませんでした。詳細は REPLICA_RESULTS.md で公開しています。
Jev はクラウド API へ同じ 24 件を送り、処理量が同時数 1 の 4.45 件/秒から同時数 8 の 27.28 件/秒まで伸びました。クラウド側のモデル数は分からないため、Mac 上の常駐数とは別の条件です。
検証コード
今回使った設問、4 モデル共通の実行コード、採点処理、単体テストは、Decision Model Benchmarks で公開しています。
複数インスタンス試験は bench_replicas.py で再現できます。次は Strands v21 を 1・2・4 個常駐させて測る例です。
python benchmarks/bench_replicas.py --model-kind strands \
  --python path/to/strands-env/bin/python \
  --source path/to/strands-decider/src \
  --model StrandsAgents/strands-decider-2B-hobson-v21 \
  --fixture benchmarks/clef_vs_laya_cases.json \
  --out results/strands-replicas.json --port-base 8120
複数インスタンス試験の条件と生結果は REPLICA_RESULTS.md で確認できます。公開済みの Strands v19/v21 の版、要求ハッシュ、応答ハッシュ、判定は python benchmarks/audit_strands_versions.py で再監査できます。